Agent应用开发从0到1完整路线
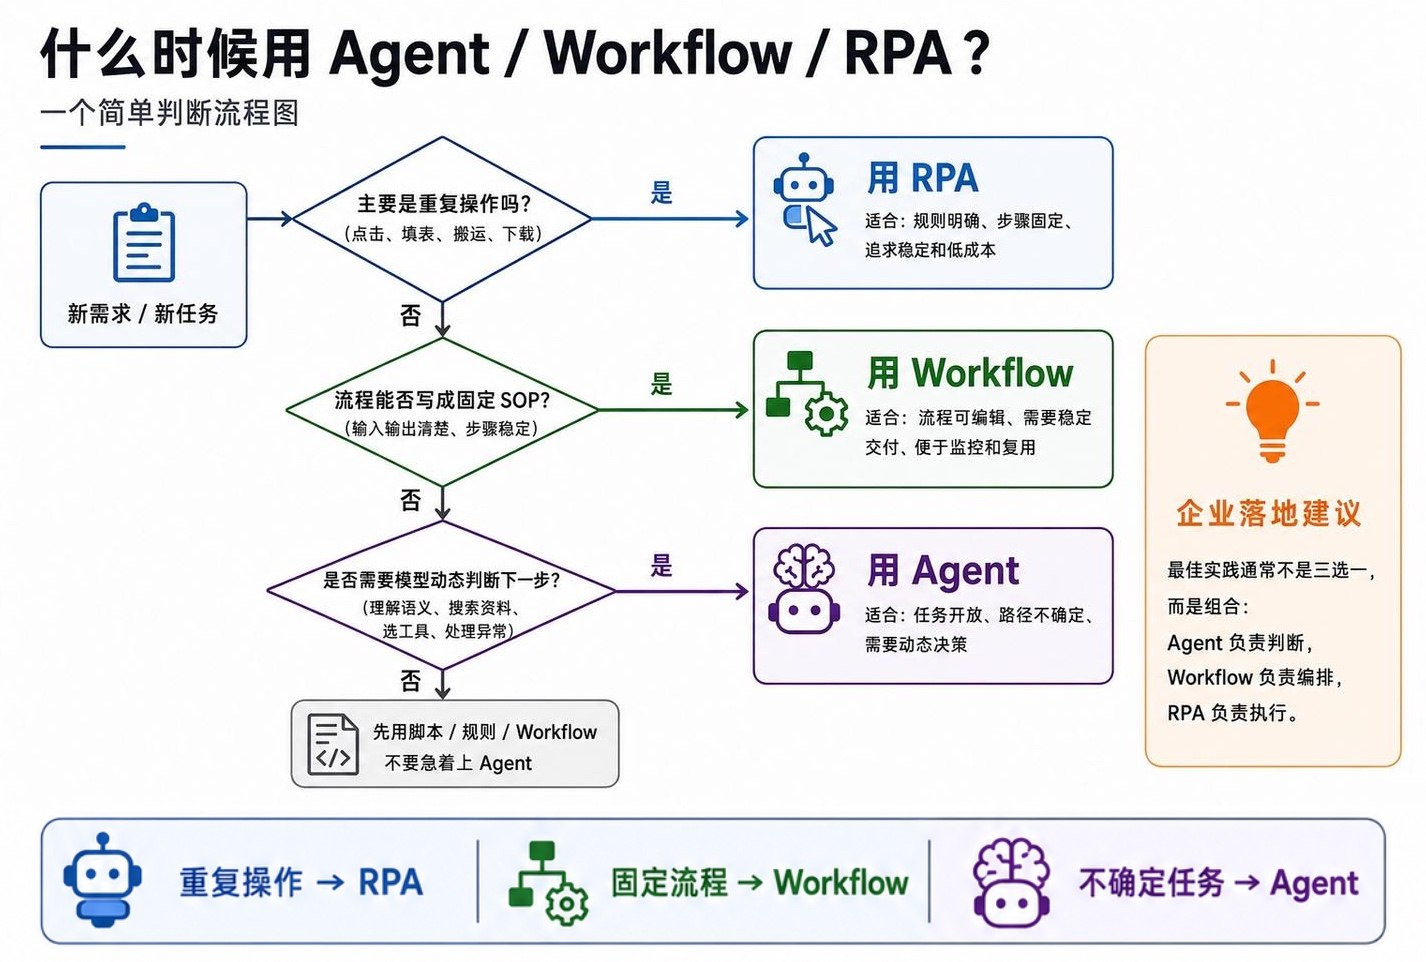
近半年来,我参与了几个企业的合作项目,主要是帮忙设计 Agent。实际上我最大的感触是:很多企业或需求一上来就奔着做 Agent 去,但实际上并不合适。
究其原因,往往是因为他们听到比如 OpenClaw 或者是像 Hermes 这样的Agent很厉害,但等实际上自己尝试一遍之后,发现效果反而不如那Workflow(工作流)的解决方式。
特别是很多时候,老老实实写个 RPA 脚本,其实一晚上就能跑通,既稳定又便宜。反而一上 LangChain,加个向量库,再加上多 Agent、Multi-Agent 这一套,最后做出来的东西又慢又不稳定,还烧钱。
最后大家甚至开始怀疑是不是 AI 不行。其实说白了,不是 AI 不行,而是往往选错了工具。
我自己部署过好几次的OpenClaw以及Hermes,最近的DeepSeek-TUI也都用过。
我的感触就是,如果你只是自己个人使用,其实像 Claude Code、Codex这类通用的 Agent 就非常好用,完全没必要自己重复造轮子。
但如果是为了商用或落地,最好还是采用“部分智能 + 高程度自动化”的形式,比如结合 RPA 或 Workflow。因为在需要落地、需要保证执行的情景下,智能化反而没那么重要,更重要的是保证输出的稳定。
但是如果要开发 AI Agent 的话,肯定还是要学的。但我不建议直接去学什么 OpenClaw 的源码,我觉得对于大多数人来说都太复杂了,最好还是按照从基础到深入的学习进度,一步步来学。
不过这种 Agent 这种新东西,最麻烦的就是理解它的概念,以及对其有一个系统性的、总体上的把握。
我建议大家有时间的话,可以去看一下知乎知学堂这节「Agent应用开发公开课」,圈内大佬提纲挈领地讲大模型知识体系、拆解Agent技术架构。你先知道这条路上有哪些模块,再去学框架,心里会稳很多。课程内容很实在,把主流大模型调用、接入业务、到一步步搭出可用的智能应用,直接拆成动作,跟着做就会产出像样的作品。
最关键的是里面配套企业级实战项目,质量是真的高!做完能写进简历,大厂面试官一眼就能看出你是做出过东西、打过仗的那种项目。
大厂出品,圈内大佬主讲,很实在、接地气,没有虚头巴脑的废话,全是干货,你直接跟着抄都能学到很多,可以放心食用~
顺便我提醒两句,
1.课程现在还能免费听,你如果真想做Agent,先把名额占了,后面再慢慢看,而且还能在群里问老师,不用自己在瞎琢磨,没有试错成本;
2.特别是配套的资料,一定要仔细看看(或者让你的agent根据你的知识进度总结一下)。加老师就能直接领Agent全套内部资源包,像 Agent从0-1 的笔记、商业大项目实战、大厂面试题库这些,对新手特别友好,直接套框架跑一遍,效率会高很多。
下面是一个八步的学习方法,下面这 8 步,就是把起点摆正。
Step 1:花半天搭一个认知地基
别一上来就写代码,先花半天到一天,搞清楚 agent 的「零件」叫什么。这步不投入,后面看任何项目你都会一脸茫然。
挑一份免费教程看一遍就够:
microsoft/ai-agents-for-beginners:微软官方,12 节课从 agent 是什么讲到工具调用、RAG、多 agent 协作。最稳的入门。
datawhalechina/hello-agents:中文版替代,Datawhale 出的系统教程,适合中文阅读。
再补一份必读:Anthropic 的「Building Effective Agents」,虽然是24年的,但是依旧非常有价值,短、密、反框架,看完你会知道大多数 agent 应该长得多简单。
如果想直接拿到一份和下面这 8 步几乎一一对应的中文系统路线图,强烈推荐:
datawhalechina/Agent-Learning-Hub:从 Stage 0「基础认知」到 Stage 8「生产部署」,覆盖最小 agent 循环、Tool Use / RAG / 记忆、agent harness、多 agent、Skills 与 MCP、浏览器 agent、评估与可观测性-一张完整的 8 阶段地图。它特别强调 Claude Code-style coding agent、OpenClaw-style 个人 agent 这些「真正在用的范式」,而不是再给你列一堆过时框架。配着这篇攻略一起看效率最高:这篇是地图,那个 repo 是详细路书。
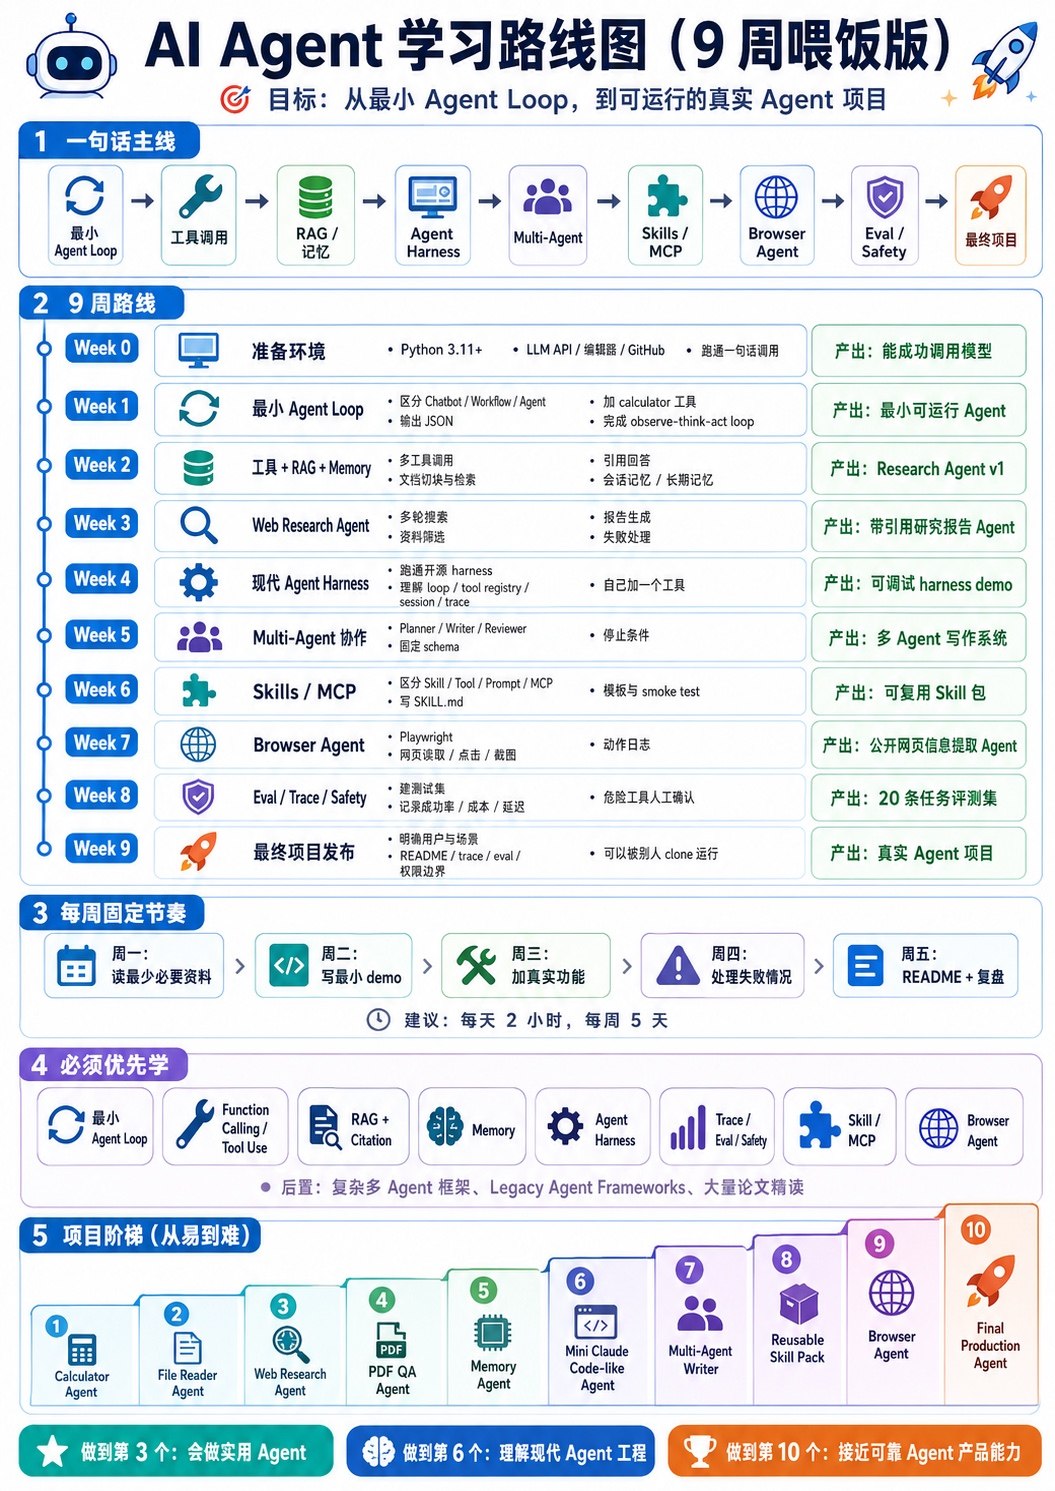
学到什么程度算够?能用自己的话讲清「LLM、Tool Use、ReAct、上下文窗口、向量检索、Embedding、Agent vs Workflow」这几个词的意思,就可以收手开干了。再啃下去,反而是拖延。
Step 2:找你自己最痛的那个场景
别先迷上「agent」这个词再到处找用途。先找你工作里最烦、最重复的那个 SOP,再想 agent 能不能接管它。
几个真有人做出来的方向找灵感:查日志和错误码、周报自动汇总、邮件分类和回复初稿、代码 review 助手、长论文整理。
判断公式很简单:流程固定 → workflow 够;路径随输入变 → 才需要 agent。
「每天把日报汇成周报」—workflow;
「用户随口提一个模糊需求,自己决定先查什么、再算什么」-这才是 agent。
再退一步:如果连模型推理都不需要-纯粹是「点按钮、复制字段、填表单」这种重复劳动,老老实实写个 RPA 脚本(Python + Playwright,或者 n8n、UiPath 这类工具)反而又快又稳又便宜。
能 RPA 就别 workflow,能 workflow 就别 agent。 工具越简单,崩的概率越低,成本越好控,维护越省心。
强行给所有东西套 agent,是新手最贵的一课。前面提到这个Agent应用开发实战营,就是带你找到痛点、机械化的业务场景,进而搭出专属的Agent一步步接管你的工作,最终无限接近智能化运营的完整闭环。真正让你释放出精力去做更多有价值、有增量的事。这里再放下领取入口:
Step 3:第一版,手写 ReAct,不要用框架
很多人入门第一件事是抱着 LangChain 啃文档。我的建议反过来:第一个 agent 千万别用框架。
理由很直接:LangChain、LangGraph 封装太厚,新手用经常是「demo 跑通了,一出问题不知道错在哪」。Anthropic 那份指南也说:最成功的 agent 往往不依赖复杂框架,而是简单、可组合的模式。
100 行 Python 内,自己手写一遍 ReAct 循环:「想一步 → 做一步 → 看结果 → 再想」。
直接调 OpenAI / Anthropic / DeepSeek 的 SDK 就行,不用任何 agent 框架。
骨架就是一个 while 循环:把任务和已有的「思考-行动-观察」历史拼成 prompt,让模型吐下一步该干啥(思考 + 动作);解析动作、调相应的工具、拿到结果(观察);再把这一轮塞回历史,循环到模型说「done」为止。就这么简单。能让它自动调一次搜索、调一次计算器、合在一起回答你一个问题,你就跑通了。
想参考一份真正「从 0 到 1 搭出来」的小 agent:
shareAI-lab/learn-claude-code:从最小 agent 一步步搭出 mini Claude Code,含工具调用、规划、子 agent、任务系统。读它的代码,比看十个 LangChain 教程都顶用。
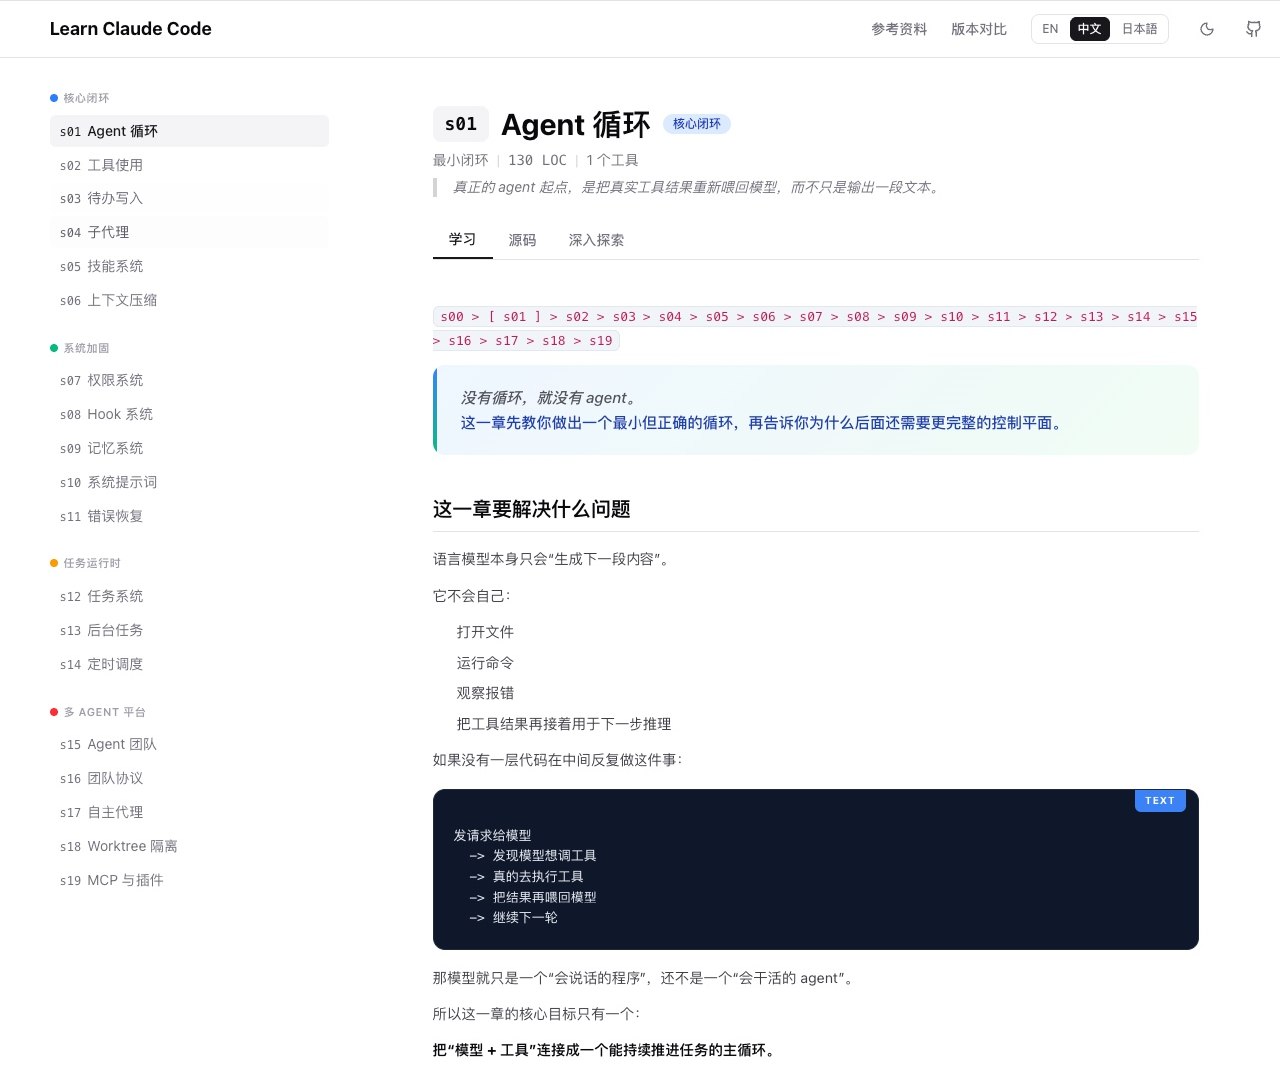
等你手写过一遍、知道每个环节在干嘛了,再回头用框架-那时候框架是省事的工具,而不是挡在你和原理之间的一层黑盒。
Step 4:把模型的输出「锁死」-结构化输出
agent 崩在哪?八成崩在「模型输出的格式不对」。
让模型「自由」吐 JSON 然后 try/except,是新手最容易写出的坏代码。专业做法是用约束解码 + 强校验,从源头让模型只能吐合法格式。
两个值得用的开源项目:
jxnl/instructor:给 LLM 加 Pydantic 约束,自动校验 + 自动重试。Python 圈最流行。
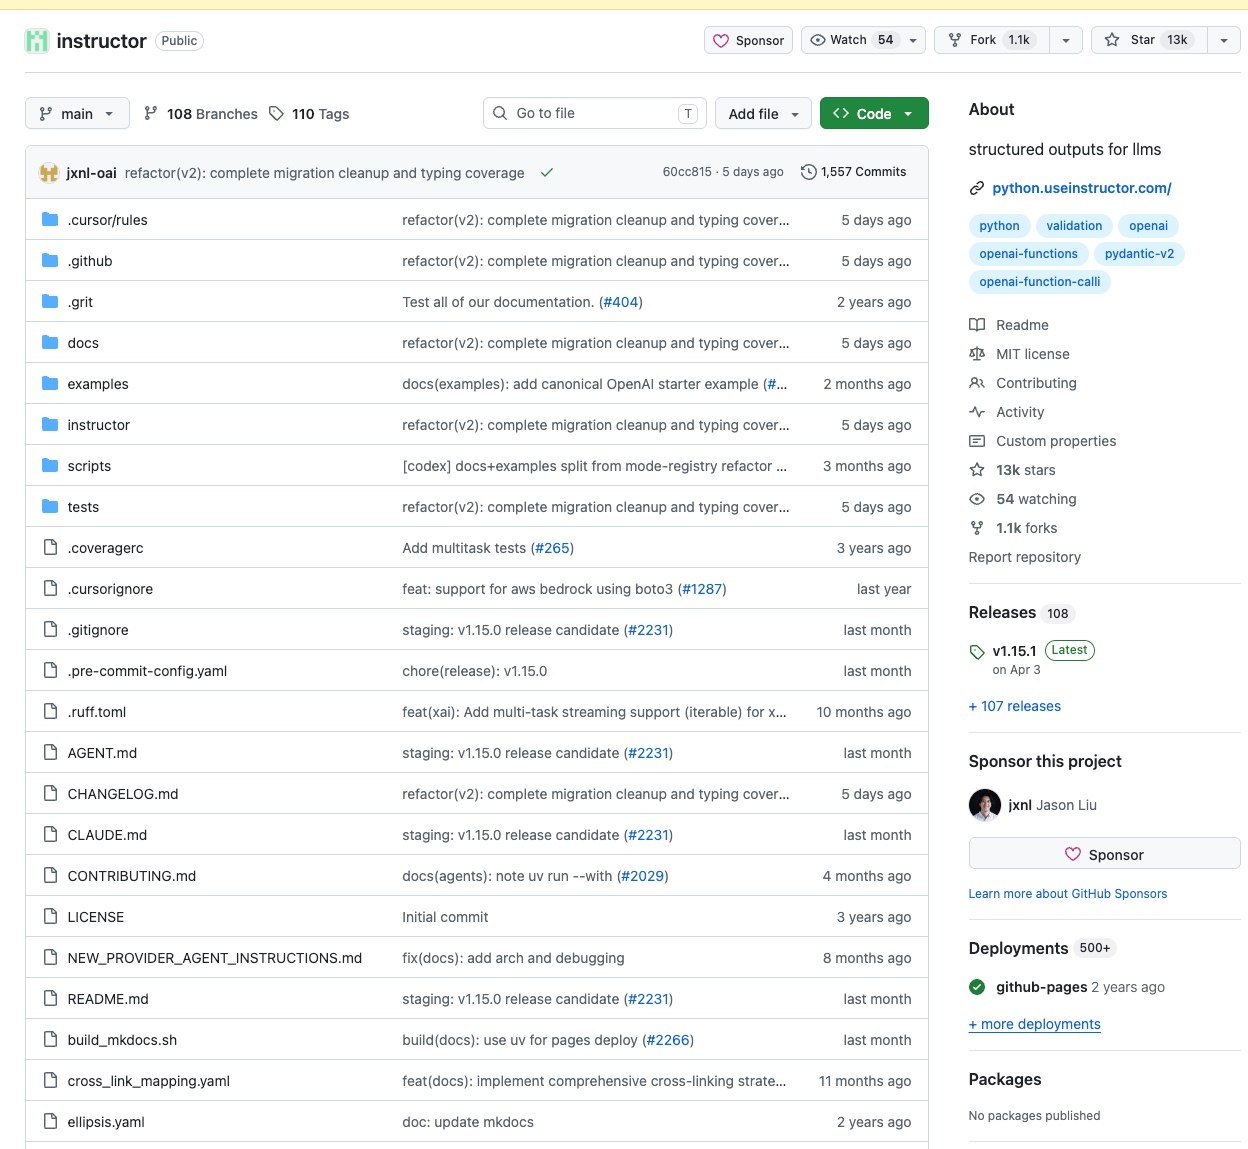
dottxt-ai/outlines:更底层,在 token 级别就不可能让模型吐错格式。
入门用 instructor 就够你跑很远。
Step 5:让 agent「会用工具」-Tool Use 与 MCP
agent 真正值钱的地方,在于它「会做事」,不只是「会说」。
学两件事:
1 Tool Use 。
写工具就是写一个「模型看得懂」的 schema-名字、参数、返回值清清楚楚。原则只有一条:动作幂等、错误明确。否则模型一旦调失败,根本不知道怎么救。
举个最小例子体会下:一个 search_logs(keyword, time_range) 工具,描述写成「按关键词搜索过去 N 小时内的服务日志,返回结构化结果数组」-模型一看就会用。反之,名字叫 do_log_thing、描述含糊,模型基本只会瞎调。工具描述写得好不好,直接决定 agent 的成败。
2 MCP(Model Context Protocol)。
Anthropic 推的协议,正在变成「agent 接外部世界」的事实标准。
modelcontextprotocol/servers:官方维护的 MCP server 集合,GitHub、Slack、Postgres、Filesystem 都有现成的。读它的代码学规范,再给你自己的业务封一个。
Step 6:加记忆 + 检索增强(RAG)
光靠对话上下文不够,agent 要扛真实业务,必须接外部知识和长期记忆。
RAG 这条 pipeline 跑通四步:
文档按章节和语义切块,别傻按 512 字硬切;
转向量存进向量库;
检索时叠 BM25 关键词做混合检索;
用 Cross-Encoder 重排。
向量库三个常用的:
chroma-core/chroma:最轻,本地玩够用。
milvus-io/milvus:生产级,亿级向量也扛得住。
qdrant/qdrant:Rust 写的,性能和扩展性都不错。
记忆这块两个值得看:
letta-ai/letta(原 MemGPT):把「长期记忆」做成了一套系统。
mem0ai/mem0:更轻量的记忆层,API 简洁。
想看一份系统性 RAG 实现做参考,run-llama/llama_index 的代码值得翻-不一定要用它,但它对每个环节的拆分非常清晰。
什么时候该加记忆?一个粗判断:你的 agent 是不是要跨多次对话记住用户的偏好或历史结论?只是单次任务、跑完就走,那对话上下文够了,别自找麻烦;只要涉及「下次还要记得这次的事」,再上长期记忆。
Step 7:建评估集-这一步决定你是新手还是老手
你的 agent 改了个 prompt 到底变好了还是变差了?凭感觉不算数。
没有评估集,你就是在黑暗里调参。
最朴素的做法:攒几十个真实任务 + 标准答案,每次改动跑一遍,看任务完成率、平均步数、错误率。
评估集不用大,但一定要「脏」-必须覆盖真实场景里那些刁钻、边界的输入。我见过太多 agent,在干净的 demo 数据上效果惊艳,一上线遇到真实用户换个问法就原形毕露,根子全在评估集太干净。
实操技巧:先从线上日志或真实对话里抽 30 条最难的、最容易翻车的,每条标注「该输出什么」-这就是你第一版评估集。后面每周新增几条就够。一周后你就会发现,这是整个工程里 ROI 最高的事。
工具推荐:
explodinggradients/ragas:RAG / agent 评估的事实标准,faithfulness、answer relevancy、context precision 几个核心指标都有现成实现。
confident-ai/deepeval:测试框架风格,用 pytest 跑 agent 测试。
langfuse/langfuse:开源 LLM observability,每一次调用的 prompt、返回、中间步骤、token 消耗都能看到。生产环境基本必备。
Step 8:扛住生产环境-成本、路由、降级
能跑通只是开始,能稳定上线还有最后一段路。
BerriAI/litellm:一份代码切 100 多家模型 API,路由 / fallback / 缓存 / 限流全有。我自己也在用。
Anthropic prompt caching:把不变的长上下文缓存住,API 费用能省到原来的 1/10。
模型分层:简单分类、抽取这类活,用便宜的小模型(Haiku、Gemini Flash、DeepSeek 小版本)就够;复杂规划再上大模型。一个 agent 里混用两三档模型,是省钱也是提效的标准做法。
降级策略:模型连续失败 N 次,自动 fallback 到更简单的逻辑或人工。这是 agent 工程师那些「不性感但值钱」的脏活。
上面这 8 步,自己摸索能走通,但你会在「各种名词」和「系统架构」这两层卡很久。我的建议:动手前花两节课的时间,把「大模型应用开发到底是怎么回事」先看一遍,省得边做边迷路。知乎知学堂这节「Agent 应用开发实战」的 0 元公开课,就是解决这个问题最实用的资源,它不教具体代码,讲的是技术架构、知识体系和岗位认知,正好适合用来把全局先看清楚。
顺手放几个值得对照的真实 agent 项目
不是让你直接用,是去读源码,看老手怎么处理那些「看上去会的、实际全是坑」的环节:
aider-AI/aider:AI 配对编程,工程化做得极成熟,是学 agent 怎么落地的最好教材之一。
princeton-nlp/SWE-agent:自动修 GitHub issue,SWE-Bench 上的常客。
browser-use/browser-use:让 agent 操作浏览器,今年极火。
mannaandpoem/OpenManus:通用 agent 开源复刻,中文社区活跃。
huggingface/smolagents:极简 agent 框架,几百行核心代码,学习友好。
挑一个跟你的场景最近的,把它的 README 和核心循环代码读一遍。比你刷十个教程涨得快。
最后
做 agent 这件事,我的态度始终一样:怕踩坑是对的,但因为怕就不动手,是最大的坑。
模型在以代际速度往前冲-DeepSeek V3.2 的「Thinking in Tool-Use」、MiniMax M2 主推的 Interleaved Thinking、Anthropic 一波接一波的 Skill 和 MCP-光看是追不上的。真正的认知,全是在「做 → 崩 → 改」的循环里长出来的。
把上面这 8 步当一张攻略图:认知地基 → 找真痛点 → 手写第一版 → 锁输出 → 接工具 → 加记忆 → 建评估 → 扛生产。每一步配的 GitHub 项目都已经验证过,直接用。
原文作者:平凡
编辑于 2026-08-10 18:25・北京